
LLM : avec Olala, OVH se prépare à se jeter dans le grand bain
Olala-v1.0-mini est à la fois le premier LLM d’OVH et le dernier de DragonLLM, devenu OVHai LLM. Si le petit modèle a déjà prouvé son utilité chez Qwant, deux chantiers d’envergure attendent le laboratoire d’IA adossé au fournisseur cloud français. Il entend bien proposer une alternative européenne à OpenAI et à Mythos d’Anthropic.
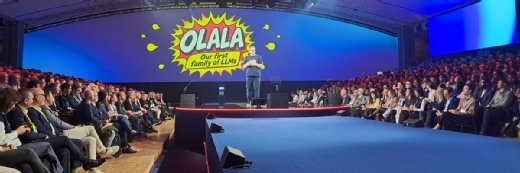
Lors de son AI Summit le 19 novembre au Carrousel du Louvres, OVHcloud a présenté le modèle de raisonnement open weight de son équipe OVHai LLM. Il est disponible depuis sa brique d’inférence AI Endpoint et Hugging Face
Pour rappel, ce laboratoire d’IA a été mis sur pied après le rachat en mars 2026 de DragonLLM. La société française auparavant nommée Lingua Custodia s’est d’abord spécialisée dans la traduction à l’aide de modèles NLP. Elle s’était mise à fine-tuner des LLM avant développer ses propres SLM (small language model).
La petite équipe d’ingénieurs (15 personnes) a lancé deux modèles de 3,6 milliards de paramètres. Elle s’apprêtait à entraîner un modèle de 7 milliards de paramètres. Le voilà, il s’appelle Olala. Il est doté de raisonnement et sa documentation (très détaillée) est conforme l’AI Act.
Sous le capot, une architecture hybride Mamba 3-Transformer
OVHai LLM a décortiqué le travail effectué par les équipes d’Alibaba sur le modèle Qwen 3.5. Il sert de référence en matière d’architecture, mais le résultat final est original. Chaque brique de cette fondation a été évaluée pour sélectionner la meilleure candidate.
Les deux modèles de DragonLLM reposaient sur l’architecture hybride Mamba 2 – Transformer. Celle-ci a été développée pour affiner l’attention des modèles sur de longs documents et réduire drastiquement le coût de calcul lors de l’entraînement. En résumé, il s’agit de combiner un Transformer avec un modèle d’espace d’état, auparavant utilisé pour les tâches de prévision.
Olala combine une double aptitude. Olala-v1.0-mini-7A1B est un modèle Mixture of Experts qui n’active qu’un milliard de paramètres associés à une architecture Mamba 3– Transformer.
La brique Mamba 3 accélère surtout l’inférence. Son mode MIMO (Multi-Input Multi Output) regroupe plusieurs flux de données pour réaliser des multiplications de matrices à chaque nouveau token généré.
Mamba 3 est aussi plus compact et plus précis que Mamba 2. C’est le gain apporté par la discrétion trapézoïdale qui remplace la discrétion d’Euler. Au lieu de traiter les mots de manière isolée, cette approche relie les mots voisins sans avoir recours à une couche de convolution (une étape de calcul supplémentaire) pour établir ce lien.
Après plusieurs tests, Olala s’appuie sur 36 couches de réseaux de neurones, dont 29 couches Mamba 3. Une sur 5 est dédiée à l’attention suivie par un bloc MoE de 256 experts. À l’inférence, un routeur sélectionne uniquement six experts actifs (7 couches sur 36 au total).
Les couches d’attention reposent sur le bloc « Differential TPA ». Cette appellation désigne une attention différentielle où deux cartes d’attention sont calculées puis soustraites afin d’éviter le bruitage et les pertes de contexte. Elle est couplée à la technique « Tensor Product Attention », qui permet de compresser jusqu’à 10 fois l’empreinte mémoire du KV Cache.
À noter qu’OVHai LLM a conservé le tokenizer de Qwen (151 936 tokens), responsable de la conversion des mots en tokens. Pour l’instant, la fenêtre de contexte est de 32 000 tokens, mais il est déjà prévu de l’étendre à 128 000 tokens d’ici à six semaines.
OVHai LLM (ex-DragonLLM) mise sur la frugalité plutôt que sur les performances pures
En clair, le modèle peut s’exécuter aussi bien sur une petite instance GPU en cloud que sur le CPU d’un ordinateur portable. Il faudra composer avec un historique de conversation limité.
Pour les besoins de Qwant, le moteur de recherche propriété d’Octave Klaba, PDG et cofondateur d’OHVcloud (à travers Synfonium), OVHai LLM a développé une version fine-tuné. Elle sert à générer les réponses « flash », équivalents aux « AI Overviews » de Google.
« Nous avons observé un gain de vitesse de 20 % par rapport au précédent modèle en place. Et nous avons divisé par trois fois nos coûts », avance Boris Lecoeur, CEO de Qwant et de Blade. « Nous utilisons l’infrastructure de Blade et nous plafonnons à 180 tokens par seconde sur une RTX A4500 [24 Go de VRAM, N.D.L.R] ». En moyenne, le modèle répond en 160 tokens/s, soit un peu plus vite que Claude Sonnet 5.5 (environ 145 tokens/s).
Qwant utilisait auparavant des modèles Mistral AI. « Le jour où Mistral a dit qu’elle allait multiplier ses prix par trois, nous sommes allés voir ailleurs », témoigne Boris Lecoeur. « Après plusieurs benchmarks, nous nous sommes dit que l’hébergement maison d’un modèle serait plus approprié qu’une API en SaaS ».
En local, un MacBook air M5 doté de 16 Go de RAM suffirait à atteindre 70 tokens par seconde. Un PC fixe doté d’un Ryzen 7 7800X3D permet de générer une réponse à la vitesse de 46 tokens par seconde. Olala-v1.0-mini peut également s’exécuter sur un GPU doté de 8 Go de VRAM.
La primeur au suivi d’instructions
Malgré sa petite taille, Olala-v1.0-mini-7A1B a été entraîné sur 1024 GPU GH200 du supercalculateur européen Jupiter. OVHai LLM a également utilisé des crédits européens pour accéder aux GPU H100 et A100 installés dans les supercalculateurs Jean Zay, en France, et Meluxina, au Luxembourg. L’équivalent de 7 millions d’euros de calcul (1,16 GWh, 40 tonnes équivalent CO2).
Au total, la division du fournisseur cloud a utilisé 12 800 milliards de tokens issus exclusivement de données publiques, dont des jeux de données constitués par Hugging Face et Nvidia.
10 400 milliards de tokens dans 36 langues différentes ont servi lors du préentraînement. Une phase « d’annealing » (de recuisson) a utilisé 2 380 milliards de tokens pour stabiliser et affiner les poids avec des données de haute qualité. Elles sont consacrées aux mathématiques, à la programmation et aux connaissances générales. Une troisième phase a permis d’étendre la fenêtre de contexte avec 44,6 milliards de tokens.
Puis, il y a eu une phase d’apprentissage supervisé (SFT) mené à l’aide de 36,9 millions d’échantillons issus de 27 jeux de données (162 milliards de tokens). Elle a servi à apprendre au modèle à se comporter comme un chatbot à raisonner avant de répondre en fonction de quatre niveaux d’effort, à utiliser des outils et à agir comme un agent IA.
Viennent enfin quatre étapes d’apprentissage par renforcement pour le suivi d’instruction et les mathématiques, le code, le comportement et l’IA agentique. « J’ai tenu à ce qu’Olala 1 soit extrêmement bon en suivi d’instruction », affirme Olivier Debeugny, CEO d’OVHai LLM et fondateur de DragonLLM. « Un petit modèle comme celui-ci doit faire partie prenante de processus d’entreprise qui requiert de la précision, par exemple le tri de documents ».
En contrepartie, la filiale d’OVH a dû contrôler le comportement de son modèle afin d’éviter les pl. « Nous avons travaillé sur les éléments d’alignement afin d’éviter des comportements toxiques », renseigne-t-il.
OVHai LLM a décliné cinq checkpoints : Olala-mini-7A1B, Olala Translate, Olala Summarise, Olala Base (le modèle sans postentraînement), Olala SFT (sans apprentissage par renforcement).
Les scores publiés par OVH sont loin des modèles frontières. Face aux LLM de sa catégorie, dont Granite 4.0-H-Tiny d’IBM et OLMoE-1B-7B, Olala-mini-7A1B est meilleur. Contre Qwen 3.5-4B et Falcon H1R-7B, il est plus efficient. « Ce n’est pas le meilleur modèle du monde, mais il n’y a pas à rougir », affirme Olivier Debeugny.
Le laboratoire recommande de l’utiliser avec des outils afin de l’alimenter en contexte. « Il a été entraîné pour lire des données au travers d’outils plutôt que d’utiliser sa mémoire pour répondre », indiquent les chercheurs.
Les requêtes doivent viser un objectif précis et non pas plusieurs. Olala-mini-7A1B est plus à l’aise en anglais et dans les langues pratiquées en Europe. Il peut tomber dans une boucle de répétition si on ne lui indique pas un budget de tokens. Il n’est pas recommandé de traiter de longs documents sur CPU et il vaut mieux ajouter des garde-fous. L’espace de démonstration fourni par OVHcloud suffit à se rendre compte que le SLM répond sans problème aux demandes les plus simples.
Vers des modèles de plus 100 milliards de paramètres pour l’IA agentique, le DevOps et la Cyber
Cela dit, pour OVHcloud et sa filiale, c’est surtout la preuve qu’elle peut entraîner de pied en cap des modèles de raisonnement et maîtriser sa pile technique. L’objectif n’est pas d’entraîner des modèles frontières, selon Octave Klaba, mais de spécialiser des LLM sur les métiers du fournisseur. Il cherche toutefois à entraîner de plus gros modèles propriétaires pour les cas d’usage agentique, le DevOps et la cybersécurité.
En 2027, OVHai LLM entraînera un modèle de plus de 100 milliards de paramètres – environ la taille des modèles de Cohere. Le laboratoire continuera de participer aux appels à candidater aux programmes liés à EuroHPC. Cela lui permettra d’utiliser les subventions européennes de calcul. Il pourra exploiter également un cluster de GPU nouvelle génération « en cours de construction » chez OVHcloud. Olivier Debeugny indique par ailleurs que son équipe doit adapter ses outils et ses méthodes à ce modèle de plus grande taille. « Nous allons continuer à améliorer l’architecture de nos modèles et à suivre l’état de l’art », indique le dirigeant.
Le gros sujet pour OVHcloud sera de proposer des modèles d’IA européens dédiés à la cybersécurité défensive et offensive (red teaming). Ils devront être plus efficients que Mythos d’Anthropic et utiliser les données d’audit collectées au fil des ans par le fournisseur cloud. « Je pense qu’un modèle spécialisé de 300 milliards de paramètres peut potentiellement égaler les meilleurs modèles au monde dans cette catégorie », anticipe Olivier Debeugny.
Les plus gros modèles open weight atteignent actuellement près de 3 000 milliards de paramètres. Les fournisseurs américains ne communiquent pas sur la taille actuelle de leur LLM.
« Le principal défi est de créer beaucoup de données réalistes en construisant divers environnements de reinforcement learning », poursuit-il. « En cybersécurité, les incidents viennent souvent d’une combinaison de facteurs, pas d’une seule faille. Il faut donc entraîner les modèles sur de nombreux scénarios complexes, idéalement avec des partenaires soumis à de fortes contraintes de sécurité ».
En la matière, Mistral AI a un train d’avance. Il spécialise déjà Mistral Large 4 avec Orange Cyber Defense et des acteurs comme BNP Paribas.
Ce n’est pas contre les acteurs en place que veut jouer OVHcloud, mais avec, affirme en substance Octave Klaba. Lors de sa conférence, il a présenté les fonctions d’interconnexion de la couche réseau de son cloud public avec AWS, Microsoft Azure et GCP. Il a également assuré que l’AI Endpoint prendra en charge une fonction de routage vers des LLM tiers, dont ceux d’Anthropic et d’OpenAI.
Pour approfondir sur IA appliquée, GenAI, IA infusée
-
![]()
Koa : Salesforce présente un modèle de raisonnement dédié à son CRM
Par: Gaétan Raoul
-
![]()
GLM-5.3 Flash, Qwen-3.8 Flash Next : zAI et Alibaba cherchent à casser les prix de l’inférence IA
Par: Gaétan Raoul
-
![]()
Kimi K3 : le Chinois Moonshot AI engage le bras de fer avec OpenAI et Anthropic
Par: Gaétan Raoul
-
![]()
Au-delà des LLM, les « harnais IA » font grimper la facture du développement
Par: Gaétan Raoul