
OpenSearch, ce fork d’Elastic Search que la Linux Foundation met en avant
Téléchargé plus de 2,4 milliards de fois depuis sa création en 2021, ce logiciel se présente aujourd’hui comme une brique fondamentale pour exposer les données ensemble aux IA. Il est surtout un exemple de solution fortement maintenue qui peut se passer d’un éditeur en chef.
Particulièrement mis en avant lors de sa conférence Open Source Summit Europe 2026, qui s’est tenu plus tôt ce mois à Prague, la suite logicielle OpenSearch incarne l’exemple même de ces forks que la Linux Foundation appelle de ses vœux pour rétablir la souveraineté des technologies en Europe. Mais c’est aussi un logiciel qui, souvent dans l’ombre de marques connues, jouerait désormais un rôle de premier plan dans les solutions vendues pour mettre l’IA en application.
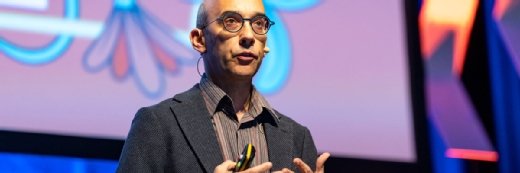
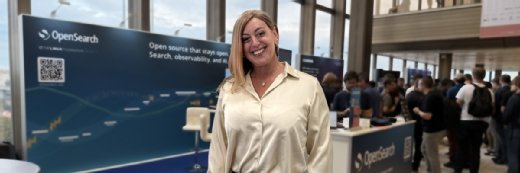
« Vous voyez de plus en plus des marques de stockage ou de serveurs vous proposer avec leurs produits des suites logicielles qui leur permettent, là, de mieux filtrer les données avant de les partager avec une IA, ou, là, de convertir les documents en vecteurs pour qu’elle puisse les traiter. Et ces extensions sont présentées comme standard, car basées sur des technologies Open source. Mais ce que vous ignorez, c’est qu’il s’agit souvent des outils d’OpenSearch », fait remarquer Bianca Lewis, la directrice de la fondation OpenSearch qui légifère le logiciel éponyme (en photo en haut de l’article), lors d’une interview accordée au MagIT.
Elle refuse néanmoins de nommer les marques auxquelles elle pense. Quant aux grands utilisateurs qui font reposer leurs services d’IA sur Opensearch, elle en cite au moins deux. Apple, qui serait même celui qui contribue le plus à améliorer les fonctionnalités d’OpenSearch. Et Uber.
Une couche d’infrastructure de données globale pour l’IA
Capable d’unifier plusieurs silos de données pour les traiter ensemble avec des requêtes directes, OpenSearch aurait été téléchargé plus de 2,4 milliards de fois depuis sa création en 2021 et bénéficierait aujourd’hui de plus de 3000 contributeurs, majoritairement en Europe, pour améliorer régulièrement son code. Son utilisation aurait augmenté de 31% sur l’année écoulée, grâce à l’explosion des projets d’IA.
« La grande force d’OpenSearch est d’amener une couche d’infrastructure de données globale pour l’IA. Il ne s’agit pas seulement de faire tomber les silos entre les applications. Avec OpenSearch, vous n'avez pas besoin d'une plateforme pour indexer vos contenus, d’une autre pour savoir qui y accède, d'une autre pour les convertir... », argumente Bianca Lewis, en prétendant que les exigences fonctionnelles de l’IA rendent obsolètes ces vieux systèmes fragmentés.
Sur le plan technique, OpenSearch trouve les informations qui répondent aux requêtes en mixant plusieurs techniques.
« Si vous gérez une entreprise dans l'industrie et que vous devez effectuer une recherche par numéro de pièce, vous ne voulez pas trouver le plus proche voisin, comme c’est le cas aujourd’hui avec les bases vectorielles généralement utilisées pour l’IA et qui ont le défaut de brûler une quantité considérable de tokens. OpenSearch a créé la recherche hybride, où nous filtrons d'abord lexicalement pour obtenir ce numéro de pièce précis, et seulement ensuite, nous appliquons les vecteurs », explique Bianca Lewis.
La prochaine évolution, sans doute la version 4 qui pourrait voir le jour en 2027, devrait favoriser davantage un fonctionnement de type base en graphe, où les informations sont parcourues de proche en proche seulement quand il existe un lien direct entre elles.
Un fork indépendant d’Elastic Search
Sur une initiative d’AWS, OpenSearch est une copie 100% Open source et indépendante des logiciels Elasticsearch et Kibana, dont l’éditeur Elastic a décidé en 2021 qu’ils devraient désormais être soumis à son bon vouloir.
La version d’OpenSearch que chacun peut librement télécharger est taillable sur mesure par tous les développeurs ou intégrateurs européens voulus pour satisfaire plus précisément les besoins de leurs clients. Ce n’est plus le cas d’Elasticsearch et Kibana. Des logiciels sur lesquels il pèse aussi le risque de ne plus pouvoir les utiliser en Europe si jamais le gouvernement des USA l’imposait à Elastic.
« Il y a une très grande distinction entre un projet Open source qui est neutre vis-à-vis des fournisseurs et un projet Open source détenu par un fournisseur, qu’il faudrait plutôt appeler Open Core. Car dans le second cas, vous restez verrouillé avec ce fournisseur, c'est une stratégie commerciale », assène Bianca Lewis.
De fait, l’ouverture maximale d’OpenSearch réunirait une communauté d’acteurs tous capables de se substituer à un éditeur officiel : « vous avez d’autres fournisseurs, comme IBM ou SAP, qui s’impliquent dans le projet pour renforcer leur activité historique, mais aussi un écosystème d’entreprises de service ou de conseil, qui considèrent OpenSearch comme une vitrine pour leur expertise », raconte Bianca Lewis.
Pour mémoire, il s’agissait de l’un des points que les membres de la Linux Foundation défendaient lors de leur discours d’ouverture de la conférence de Prague : l’Europe ne deviendra pas indépendante des fournisseurs américains si elle se contente d’utiliser des logiciels Open source ; elle le sera si elle se trouve des fournisseurs locaux capables de maintenir ces solutions comme le ferait un éditeur.
Pour approfondir sur Intelligence Artificielle et Data Science
-
![]()
L’Open source au secours de la souveraineté de l’UE ? Seuls les citoyens y croient
Par: Yann Serra
-
![]()
Now Summit : Mistral AI conjugue IA agentique et cloud hybride
Par: Gaétan Raoul
-
![]()
Dell World 2026 : l’AI Factory devient une infrastructure pour l’inférence
Par: Yann Serra
-
![]()
DBaaS : AWS met l’accent sur la maîtrise des coûts
Par: Gaétan Raoul