
Puces IA : AMD consolide son offre avec les puces de Taalas
Le numéro 2 des GPU rachète la startup canadienne qui a mis au point une puce d’accélération HC1 pour l’inférence. Si ce rapprochement rappelle celui de Nvidia avec Groq, on ignore encore comment AMD entend conjuguer cette technologie avec le reste de son catalogue.
AMD continue de calquer sa stratégie IA sur celle de Nvidia. Le géant des puces, après s’être mêlé en juillet de concevoir un cluster de serveurs Helios, similaire aux DGX de son concurrent, rachète la startup canadienne Taalas, qui fabrique une puce d’inférence, tout comme Nvidia a mis la main sur Groq. Là aussi, il ne s’agit pas de récupérer une technologie pour améliorer celle de ses propres GPU, mais plutôt d’avoir au catalogue une puce accélératrice-bis, qui comblera rapidement certains besoins des clients.
« AMD construit une plateforme IA full-stack qui donne aux clients la flexibilité de déployer les solutions de calcul appropriées pour chaque charge de travail IA. La technologie et l’équipe d’ingénierie de classe mondiale de Taalas renforcent notre portefeuille IA, en offrant des performances et une efficacité d’inférence différenciées », commente ainsi dans un communiqué Vamsi Boppana, qui dirige la branche IA d’AMD.
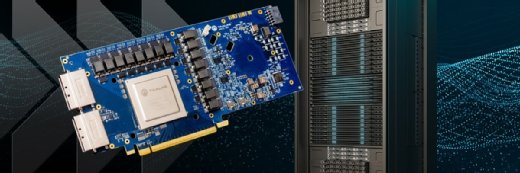
Taalas a mis au point une puce HC1, qu’il vend sur une carte PCIe éponyme, capable de générer près de 17 000 tokens par seconde avec le LLM Llama 3.1 en 8 milliards de paramètres de Meta, alors qu’un GPU Nvidia B200 ne saurait produire que 594 tokens par seconde dans les mêmes conditions.
Toutefois, ce genre de petits LLM qui sert à trouver rapidement des réponses, au détriment de la précision de ces réponses, est rarement utilisé sur un GPU haut de gamme. Un premier scénario d’utilisation consisterait donc à déployer des cartes HC1 en complément de GPU plus puissants et à répartir au niveau des serveurs les tâches d’IA entre les deux familles d’accélérateurs, selon le but applicatif recherché. Mais rien ne dit que ce soit réellement la stratégie d’AMD.
Un pool de petites puces pour épauler moins de GPU trop chers
La répartition de LLM de différentes tailles sur des GPU différents n’est pas encore une approche très mature. Dans les faits, les communautés de développeurs commencent à peine à bâtir des technologies comme LLM-d qui rendraient possible ce genre de routage.
Un autre scénario serait qu’AMD entende mimer l’architecture mise au point par Nvidia et dans laquelle la petite puce accélératrice LPU Groq endosse une partie des traitements effectués par ses GPU lors des tâches d’inférence.
Dans celle-ci, les GPU de Nvidia continuent d’effectuer les calculs en parallèle, qui interprètent l’ensemble d’un prompt (pour trouver une relation mathématique entre tous les mots d’un prompt), et un pool de LPU Groq génère l’un après l’autre les mots qui forment la réponse à ce prompt en allant les collecter dans la base de connaissance d’un LLM. Dans ce fonctionnement, la taille du LLM n’est pas un problème, car elle est répartie sur la quantité de LPU présents dans le pool. AMD, qui imagine vendre des puces Taalas HC1 en complément de ses GPU MI455X, aurait certainement la même approche.
Économiquement, ce type d’architecture est efficace, car, dans sa dernière version Groq-3, le LPU stocke un bout de LLM dans une mémoire cache SRAM à laquelle il accède à la vitesse de 150 To/s, alors qu’un GPU Rubin accède à sa mémoire HBM à la vitesse de 22 To/s. Le bénéfice est donc de libérer du temps de calcul au GPU, pour qu’il puisse plus rapidement décoder le prompt d’un autre utilisateur, puis le passer aux LPU qui auront terminé de générer leur réponse précédente plus rapidement que ne l’aurait fait le GPU.
En pratique, cela permettrait à un hébergeur de commercialiser sept fois plus de tokens par fraction de temps, ou à une entreprise de déployer moins de GPU que prévu pour servir un nombre donné d’utilisateurs simultanés.
Des contraintes qu’il reste à contourner
La concrétisation d’une telle architecture mixte dépendra surtout de la capacité d’AMD à contourner les inconvénients qu’elle pose. Le premier est que, chez Nvidia, il faut beaucoup de puces LPU pour répartir l’ensemble d’un LLM dans leurs petites mémoires caches. À raison de 500 Mo de mémoire cache par puce LPU Groq-3, il est nécessaire de déployer 256 puces (la configuration d’un rack LPX de Nvidia) pour travailler avec un LLM d’environ 100 milliards de paramètres.
On ignore combien Nvidia facture un rack LPX, mais il assure avoir trouvé la bonne formule pour qu’un rack de GPU DGX accolé à un rack LPX soit plus rentable qu’un rack DGX seul. En tout cas, chez un hébergeur à qui cela permet de revendre sept fois plus de tokens. C’est-à-dire que la solution n’est pas destinée à un usage privé sur des serveurs d’entreprise.
L’autre inconvénient est le coût de la consommation électrique. Selon la startup Taalas, un serveur entier équipé de sa carte consommerait 2500 watts. Cela paraît beaucoup. Un processeur de type AMD Epyc 9005 ou 9006 consomme entre 400 et 600 W et le reste de la carte mère, moins de 200 W ; ce qui suggère que la carte HC1 consomme en elle-même dans les 1700 W, soit au moins 1300 W de plus qu’un LPU Groq-3.
En fait, cette consommation équivaut à celle des GPU dernier cri. Les actuels GPU Nvidia B200 et AMD MI355X consomment respectivement 1200 et 1400 W. Les prochains Nvidia Rubin et AMD MI455X devraient consommer entre 1800 et 2300 W, pour le premier, et entre 2000 et 2500 W, pour le second.
La facture serait donc, à l’inverse, plus pénalisante à l’échelle d’un hébergeur qui cumule des centaines, voire des milliers de puces, qu’à celle d’une entreprise qui n’installerait que quelques cartes HC1 dans ses serveurs en complément d’un seul GPU, par exemple pour travailler avec des LLM de 20 à 30 milliards de paramètres.
En définitive, les perspectives que cette puce HC1 va offrir soit aux serveurs d’entreprises, soit aux hébergeurs ne sont pas claires et il n’est pas si étonnant qu’AMD se garde bien de les évoquer dans son communiqué.
En revanche, là où les puces HC1 de Taalas « renforcent » véritablement le catalogue IA d’AMD, c’est qu’elles devraient moins souffrir de pénurie sur le marché que ses autres composants. En effet, des puces comme le HC1 de Taalas et le LPU de Groq sont fabriquées avec une finesse de gravure en 6 nm dans des usines plus anciennes, qui sont moins sollicitées que la seule de TSMC capable de graver les derniers GPU d’AMD et Nvidia avec une finesse de 2 nm. Les HC1 devraient donc dans tous les cas permettre à AMD d’avoir quelque chose à vendre à des clients auxquels il ne pourrait pas fournir suffisamment de GPU.
Pour approfondir sur Hardware IA (GPU, FPGA, etc.)
-
![]()
Antitrust : le rapprochement entre Groq et Nvidia remis en question
Par: Yann Serra
-
![]()
Résultats financiers : comment Nvidia bat tous les records
Par: Yann Serra
-
![]()
« Nous vivons une crise existentielle des infrastructures IA »
Par: Alain Clapaud
-
![]()
Computex 2026 : Intel rapproche son catalogue de celui de Nvidia
Par: Yann Serra