
Puces IA : Intel finalise les détails de son super GPU pour l’inférence
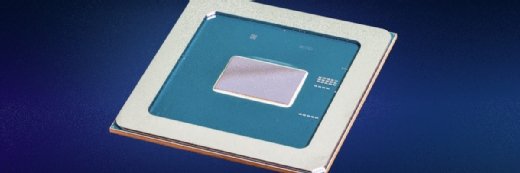
Crescent Island prendra la forme d’une carte PCIe Intel GPU-D270. En un exemplaire dans un PC, elle exécutera des modèles d’IA de 300 milliards de paramètres. En huit exemplaires dans des serveurs refroidis à l’air, ce sera trois fois plus.
Intel a profité de la conférence OCP Global Summit qui se tient cette semaine dans la Silicon Valley pour dévoiler les détails définitifs de son GPU Crescent Island. Une puce accélératrice pour l’inférence grâce à laquelle le fondeur espère rattraper son retard dans les infrastructures d’IA.
Ce GPU, finalement nommé Intel GPU-D270, sera commercialisé sous la forme d’une carte PCIe traditionnelle, enfichable dans le commun des serveurs que l’on trouve dans les datacenters, voire dans un PC au format tour. Et avec un refroidissement par ventilation, lui aussi tout ce qu’il y a de plus classique. C’est le premier fait saillant : on est loin des accélérateurs d’IA de Nvidia et d’AMD qui nécessitent avant tout de reconstruire les datacenters sur la base d’une plomberie infernale pour refroidir les serveurs à l’eau.
« Avec l'Intel GPU de série D, nous nous concentrons sur le fait de rendre l'inférence à haute capacité pratique et économique à déployer (...) Car à mesure que les modèles ouverts remodèlent l'économie de l'IA agentique, la demande croît pour une infrastructure plus flexible, rentable et efficace en termes d'énergie », vante Anil Nanduri, le patron des produits pour datacenters dans un communiqué.
Il n’est pas nécessaire de refroidir les serveurs à l’eau, car l’Intel GPU-D270 chauffe aussi peu qu’une carte PCIe traditionnelle. Il consomme (et dissipe) 350W, contre 2300W pour le dernier Rubin R100 de Nvidia et 1400 W pour le MI455X d’AMD. Et, ce, alors que le GPU d’Intel embarque davantage de mémoire qu’eux : 480 Go. Il n’y a que 432 Go sur le dernier MI455X d’AMD et seulement 288 Go sur le Rubin R100 de Nvidia. La raison est que sa mémoire monumentale repose sur des circuits LPDDR5X externes à la puce, alors que les concurrents superposent des circuits HBM à l’intérieur.
On parle ici de puces qui ne seront pas sur le marché avant 2027. Mais le GPU-D sera même moins énergivore que les actuels Nvidia B300 et AMD MI355X, tous deux consommant 1400W pour 288 Go de mémoire HBM.
Plus de mémoire, mais moins de puissance : ce qu’il faut pour l’inférence sur site
Revers de la médaille, le GPU-D270 n’intégrera pas autant de puissance de calcul que ses concurrents. Il n’atteint que 1,3 pétaflops (millions de milliards d’opérations à la seconde) en FP8, contre 20,13 sur le MI455X et 17,5 sur le Rubin R100.
Mais peu importe : la puissance de calcul ne sert véritablement que pour entraîner le plus rapidement possible un nouveau modèle d’IA. Intel vise plutôt le marché de l’inférence, un domaine où la quantité de mémoire compte davantage pour y stocker des modèles d’IA plus grands (donc plus précis) et un plus grand nombre de contextes utilisateur simultanés.
Intel estime qu’une seule carte GPU-D270 peut exécuter un modèle de 300 milliards de paramètres, tandis qu’un maximum de huit cartes par serveur pourrait exécuter un modèle de plus de 1000 milliards de paramètres. Dans ces conditions, les modèles, avec une précision 8 bits, occuperaient respectivement 66 et 25% de la mémoire du GPU, laissant le reste pour les fenêtres de contexte des utilisateurs.
Les autres détails techniques désormais connus sont que l’Intel GPU-D se compose de 32 cœurs Xe3P et 256 cœurs XMX, qu’il fonctionne à une fréquence de 2,5 GHz et qu’il dispose d’un cache de 32 Mo. La bande passante de 1,5 To/s entre la puce et la mémoire LPDDR5X se fait via un bus large de 1280 bits, où chaque connexion transporte 9375 Mbit/s.
On ignore toujours quand le GPU-D270 sera disponible, mais Intel assure avoir commencé à en livrer des préversions à certains clients.
Pour approfondir sur Hardware IA (GPU, FPGA, etc.)
-
![]()
Puces IA : l’hyperscaler Azure présente son nouveau GPU Maia 300
Par: Yann Serra
-
![]()
Processeurs : Intel annonce la fin de son chiffrement historique
Par: Yann Serra
-
![]()
Hot Chips 2026 : OpenAI présente son GPU Jalapeño
Par: Yann Serra
-
![]()
Infrastructure d’IA : l’UE lance son projet AI Gigafactories
Par: Yann Serra