
Puces IA : l’hyperscaler Azure présente son nouveau Maia 300
Prévue pour 2027, la nouvelle puce accélératrice est sur le papier plus performante que celles des autres hyperscalers, tout en restant en deçà des GPU d’AMD et Nvidia. Elle devrait permettre aux datacenters d’Azure de générer sept fois plus de tokens qu’actuellement.
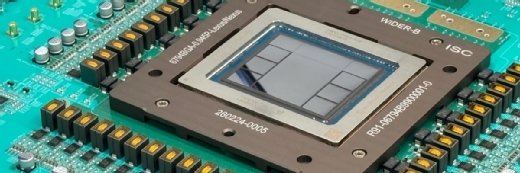
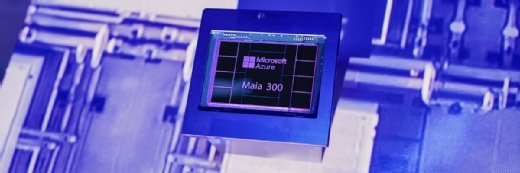
L’hyperscaler Azure vient de présenter la dernière génération de la puce qui accélère ses services d’IA en ligne, le Maia 300. Prévu par une disponibilité courant 2027, ce GPU est décrit comme particulièrement optimisé pour l'inférence et les agents. En termes de fonctionnalités, il devrait permettre aux IA de raisonner sur des fenêtres de contexte plus longues. Les IA en question sont principalement toutes les variétés d’agents CoPilot de Microsoft, ses modèles MAI et les LLM d’OpenAI, tous hébergés par Azure.
« L’enjeu est de supporter des traitements plus complexes. Pour ce faire, nous avons travaillé sur une architecture qui réduit les mouvements de données, mais en même temps supporte des bandes passantes plus importantes avec l’extérieur », explique dans un billet de blog Rani Borkar, la patronne des développements matériels internes à Azure.
Elle évoque notamment la croissance de la mémoire HBM embarquée, qui grimpe désormais à 288 Go avec un débit de 18 To/s, contre 216 Go avec un débit de 7,1 To/s sur l’actuel Maia 200. Ainsi que l’apparition d’une conception de type NUMA, soit la possibilité pour une puce d’aller lire la mémoire d’une autre sans passer par tout un empaquetage des données, comme c’est d’ordinaire le cas sur le réseau. La bande passante annoncée entre deux Maia 300 est de 750 Go/s.
Sur le modèle précédent, le Maia 200, Azure avait déjà introduit un dispositif original en ce qui concerne la problématique de la latence des données. Appelé SDLA (Software-Defined Locally-Accessed dataflow architecture), celui-ci ne déclenche l’exécution d’un flux d’instructions qu’à partir du moment où l’on est certain que les données que ce flux doit traiter sont en train d’arriver dans la puce. Partout ailleurs, la puce exécute d’abord les instructions, lesquelles demandent de récupérer des données, puis la puce se tourne les pouces en attendant leur arrivée.
Parmi les autres progrès saillants, Rani Borkar évoque évidemment, comme c’est désormais la tradition dans ce genre de présentation, que ces gains de performances permettront des économies d’énergie. Du moins, si on consent à s’arracher les cheveux pour comparer des ratios de nombre de tokens générés par électricité consommée par unité de temps, entre les Maia 200 et 300. Toutefois, il n’est dit nulle part qu’Azure baissera les tarifs de ses services d’IA quand le Maia 300 les motorisera. Quant à l’écologie, le Maia 300, gravé avec une finesse de 2 nm chez TSMC, a un TDP de 950 watts, alors que celui de son prédécesseur, gravé en 3 nm, était de 750 watts.
Pour rappel, la mise au point de puces accélératrices maison par les trois principaux hyperscalers américains que sont AWS, Azure et Google Cloud relève d’une stratégie visant à réduire leur dépendance envers les fabricants de GPU Nvidia et AMD. AWS devrait détaillera son Trainium4 (ou son Inferencia) lors de sa conférence annuelle en décembre prochain. Google Cloud a quant à lui annoncé ses TPU 8 en avril dernier.
A priori meilleur que les GPU des autres hyperscalers, mais inférieur à ceux d’AMD et Nvidia
Au jeu de caractéristiques techniques, le Maia 300 prend sur le papier l’avantage par rapport aux autres puces accélératrices que proposent les hyperscalers. Mais les GPU des fabricants spécialisés restent les mieux-disants. Le GPU Rubin R100 de Nvidia propose une capacité identique de mémoire HBM identique (288 Go), mais avec une bande passante supérieure (22 To/s), tandis que le MI455X d'AMD domine avec ses 432 Go de mémoire HBM et 23,3 To/s.
Rappelons que les IA ne travaillant qu’en mémoire, un maximum de HBM accolée à la puce accélératrice est garant de modèles plus évolués, avec davantage de milliards de paramètres, d’un plus grand nombre d’utilisateurs simultanés avec chacun des fenêtres de contexte plus grandes.
Cette course à la plus grande quantité de mémoire pour des puces accélératrices qui seront déployées en dizaine de milliers d’exemplaires dans les datacenters des hyperscalers est, rappelons-le, la cause de l’actuelle pénurie de mémoires dans les machines que les consommateurs aimeraient plutôt installer sur site.
Ces caractéristiques techniques s’accompagnent de performances pour l’instant uniquement observées, si ce n’est théorisées, par chaque fournisseur. En précision 8 bits, le Maia 300 6,9 atteindrait pétaflops (6,9 millions de milliards d’opérations à la seconde), contre 17,5 pour le Nvidia R100 et 20,13 pour l’AMD MI455X. Ces chiffres sont doublés en précision 4 bits. Cette dernière génère cependant des résultats moins précis (surtout lorsqu’il s’agit de travailler sur des documents écrits dans une autre langue que l’anglais) et on ignore si elle est réellement utilisée ailleurs que sur les machines personnelles disposant de peu de mémoire GPU.
12 288 puces accélératrices interconnectables
La force des hyperscalers se situe en revanche dans leur meilleure faculté à faire communiquer en réseau un très grand nombre de puces. Avec le Maia 3000, Azure promet de pouvoir faire travailler de concert jusqu’à 12 288 puces accélératrices, soit 128 baies rack contenant chacune 96 GPU, à raison de 4 GPU par serveurs (soit 24 serveurs par baie). C’est deux fois mieux qu’avec le précédent Maia 200, mais cela reste inférieur aux 134 000 TPU 8 que Google Cloud promet d’atteindre.
La faculté d’interconnecter autant de puces permet d’avoir un immense pool de puissance de calcul au sein duquel un maximum d’utilisateurs ou d’agents peuvent être répartis à chaque fois qu’ils interagissent avec une IA. L’idée maîtresse de la rentabilité des hyperscalers est d’occuper en permanence tous les calculateurs, quitte à ce qu’une même conversation entre une IA et un utilisateur change de GPU à chaque interaction. Pour ce faire, il faut que le GPU suivant puisse accéder le plus rapidement possible à l’historique de la conversation idéalement encore stockée dans la mémoire du GPU précédent.
Chez Nvidia et AMD, les communications directes entre GPU n’ont lieu qu’au sein de la même baie rack. Dès qu’on en sort, les données doivent être routées sur un réseau dont la logique de fonctionnement crée de la latence.
Azure reconnaît qu’il existe aussi une latence quand une communication sort de l’un de ses serveurs, et même une latence trois fois plus grande quand la communication sort d’une baie de ses serveurs. Pour autant, il ne s’agirait ici que d’un effet de bord dû aux seuls liens physiques (des fibres optiques, avec des relais) et la latence observée serait sans commune mesure avec celle générée par une logique de routage propre aux switches Ethernet.
Qui plus est, Azure assure avoir particulièrement amélioré son algorithme de distribution des tâches pour cantonner au maximum les communications au sein d’un même serveur. Cette architecture, combinée à des performances deux fois meilleures (par watt, par unité de temps...) entre les Maia 200 et 300, incite Azure à déclarer que ses racks de serveurs dotés de la nouvelle puce accélératrice produiraient chacun 7 fois plus de tokens que les précédents.
L’hyperscaler parle ici de l’efficacité opérationnelle de ses datacenters qui, par ailleurs, consomment des ressources naturelles (eau, électricité...) au point de commencer à créer une certaine animosité chez les citoyens vivant alentour. Cette efficacité est à pondérer sachant que les Maia 300 consomment plus de ressources que les Maia 200. Azure reconnaît ainsi que ses nouveaux racks de serveurs seraient in fine 2,5 fois plus performants « par watt ».
Pour approfondir sur Hardware IA (GPU, FPGA, etc.)
-
![]()
Hot Chips 2026 : OpenAI présente son GPU Jalapeño
Par: Yann Serra
-
![]()
PDG de Nvidia : « nous atteindrons un CA de 1000 milliards de dollars en 2027 »
Par: Yann Serra
-
![]()
GTC 2026 : maintenant, Nvidia part à la conquête des serveurs
Par: Yann Serra
-
![]()
IA : une nouvelle loi pour asseoir la suprématie des USA
Par: Yann Serra