
Face à la surcharge de l’IA agentique, GitHub accélère la réarchitecture de sa plateforme
En pleine migration vers le cloud Azure, GitHub s’est pris de plein fouet la surcharge du trafic des agents IA. Une situation qui pousse la filiale de Microsoft à revoir son architecture. L’éditeur a commencé par son système de réplication et compte bien découpler le stockage des dépôts du calcul lié aux opérations git.
Après une année ponctuée de nombreux incidents (257 comptés par IncidentHub, entre mai 2025 et avril 2026, dont 48 pannes majeures et plus de 110 heures d’indisponibilité), GitHub et Microsoft font amende honorable.
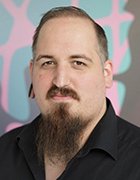
« Nous avons rencontré des difficultés, mais cela s’explique en grande partie par la croissance et l’ampleur du phénomène agentique », considère Jay Parikh, vice-président exécutif de l’équipe CoreAI chez Microsoft. Il s’exprimait lors du keynote d’ouverture de GitHub, le 28 octobre. « Cela ne doit toutefois pas servir d’excuse », ajoute-t-il d’emblée. « Nous allons et nous devons faire mieux ».
Des charges de travail multipliées par trois en deux ans
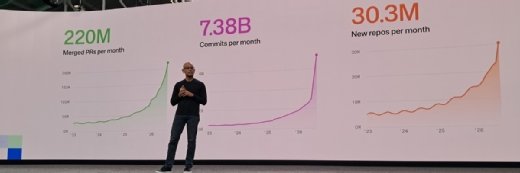
Entre septembre 2025 et septembre 2026, « le nombre de pushes a atteint 17,9 milliards, le nombre de commits est passé à 34,3 milliards », remarque-t-il. Le volume de pull requests mergées s’établit à 1,3 milliard, tandis que l’éditeur a dû gérer 45,4 milliards de jobs GitHub Actions.
En 2024, GitHub comptait 5,2 milliards de pushes, 10 milliards de commits, 8 milliards de jobs Actions et 402 millions de pull requests mergées. En deux ans, le volume d’interaction sur sa plateforme a été multiplié par trois et jusqu’à cinq fois pour les jobs Actions.
Les signes avant-coureurs de cette tendance sont se fait ressentir dès le mois de mars 2025, puis elle s’est confirmée en novembre 2025, à la sortie des modèles de la collection Claude 4.5 d’Anthropic. Mais le point d’inflexion pour la filiale de Microsoft, c’est le mois de juin 2026. Les développeurs qui se sont mis à utiliser de manière intensive les modèles d’IA à partir du mois de janvier 2026 ont adopté les agents IA, les harnais et les outils associés. Depuis le mois de septembre, plus de 40 % des pull requests sont générées par des agents, contre 17 % en mars 2026.
L’architecture de GitHub n’était pas prête pour de tels niveaux d’activité. « La bonne nouvelle, c’est que nous y travaillons d’arrache-pied, et la première mesure que nous avons prise a consisté à augmenter considérablement nos capacités cette année », affirme Jay Parikh.
En 2026, GitHub a installé 4 millions de nouveaux vCPU, 160 pétaoctets de stockage et a revu ses capacités réseau pour atteindre une vitesse de 50 Tb/s (6,25 To/s). L’éditeur ne précise pas si ces éléments équipent uniquement ses data centers ou s’ils correspondent aussi aux ressources utilisées sur Azure. « Nous sommes également en train d’accélérer notre migration vers Azure », poursuit Jay Parikh.
C’est l’autre phénomène qui explique les problèmes de disponibilité de la plateforme de gestion de version code. La migration a pour objectif de se séparer des data centers de GitHub pour les remplacer par deux régions cloud Azure aux États-Unis. Actuellement, elle est accomplie à 70 % et sera terminée au cours du premier semestre 2027, anticipe Jakub Olesky, vice-président senior ingénierie logicielle chez GitHub.
Pour ne pas perturber le fonctionnement de son système, GitHub a mené une migration brownfield. L’architecture en place a été en quelque sorte copiée puis collée sur Azure. La région Azure européenne utilisée par GitHub pour son édition Enterprise est séparée, précise-t-il.
Cela ne concerne pas GitHub Actions et GitHub Copilot, qui étaient déjà hébergés sur le cloud de Microsoft. Si ces services ont connu des problèmes, c’est du fait de la charge et des intrications avec les composants distants.
En effet, les composants principaux de la plateforme s’exécutent en parallèle sur Azure et sur les centres de données de GitHub. En août, 58 % des charges de travail de la plateforme et la moitié des opérations Git étaient pris en charge par le cloud de Microsoft.
Le système de réplication, le coupable désigné par GitHub
Or, la vitesse à laquelle les agents lisent et écrivent affecte non seulement l’infrastructure de GitHub Actions (qui a connu trois fois plus d’incidents que les opérations Git, selon IncidentHub), mais également le système de réplication de fichiers de GitHub, Spokes.
Les dépôts sont stockés dans un format blob et répliqués entièrement cinq fois sur des disques locaux. Lors des opérations Git, la lecture est rapide et la redondance est assurée. En tout cas, c’est vrai lorsque les humains poussent du code.
Chaque mise à jour par une opération push enclenche « un protocole de validation en trois phases qui utilise un quorum pour garantir que la CI, l’interface utilisateur web et les clients API voient un état cohérent du dépôt », expliquent des ingénieurs chez GitHub, dans un billet de blog. « Cependant, le mécanisme que nous utilisons pour la durabilité est le même que celui utilisé pour la mise à l’échelle. Les copies sur disque constituent la source de vérité. Ainsi, augmenter la capacité de lecture revient à ajouter une réplique durable supplémentaire », ajoutent-ils.
Toutes les répliques participent à chaque écriture. La vitesse d’une opération de type push dépend donc de la réplique la plus lente.
D’autres difficultés sont à prendre en compte. L’ajout de répliques pour absorber la charge de lecture ralentit l’écriture. De même, la perte d’une réplique réduit la capacité de lecture. Si le quorum tombe, les écritures s’arrêtent.
« Au cours de l’année écoulée, nous avons migré la quasi-totalité des dépôts Git vers Azure, mais pour une centaine d’entre eux, parmi les plus sollicités, même un délai de 25 millisecondes entre les centres de données avait son importance », explique April Leonard, vice-présidente de l’ingénierie chez GitHub, lors du keynote d’ouverture.
Plus spécifiquement, l’écriture dans un fichier et sa copie au sein des data centers de GitHub prend deux millisecondes. C’est l’envoi de la cinquième réplique vers Azure qui réclame 25 ms. Cela paraît peu, mais cela voulait dire que les requêtes d’écriture s’accumulaient dans une file d’attente. Ce qui peut évidemment causer des problèmes.
« Nous avons donc modifié la manière dont Git gère les écritures », enchaîne April Leonard. « Au lieu de verrouiller l’intégralité d’un dépôt à chaque écriture, nous ne verrouillons désormais que la branche en cours de mise à jour. Les agents travaillant sur différentes branches peuvent désormais opérer en parallèle, ce qui permet d’obtenir un débit d’écriture 3 à 4 fois supérieur », assure-t-elle. Cette parallélisation évite de saturer la file d’attente.
Découpler (enfin) le calcul du stockage
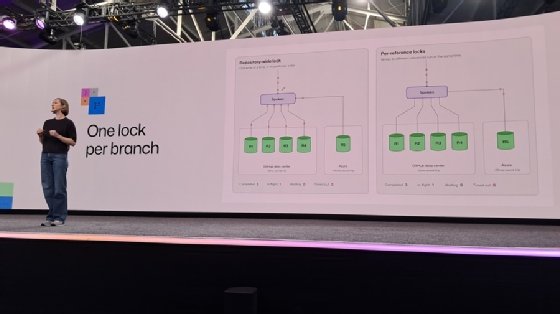
Ce n’est qu’une solution temporaire. Après la phase de migration vient le temps du re-platforming. D’abord, à la manière de S3, Azure Blob Storage gérera automatiquement les réplications, souligne Jakub Olesky. GitHub se prépare ainsi à une séparation du calcul et du stockage.
« Votre code sera ainsi stocké de manière durable dans Azure Blob Storage qui fera office de source de vérité », poursuit April Leonard. « Les serveurs qui répondront aux requêtes GET mettront ces données en cache pour gagner en rapidité. Ce cache est éphémère : cela nous permettra d’augmenter la capacité à mesure que la demande croît ».
« Nous réduirons ainsi au minimum la coordination. Seule la petite transaction de référence reste sur le chemin critique ; elle sera gérée par un service de journalisation répliqué spécialisé, optimisé pour la vitesse ».
Dans le détail, l’espace de stockage objet devient un membre du quorum, une réplique virtuelle. « Comme il fait partie du quorum, une écriture n’est validée qu’une fois qu’elle est stockée de manière durable dans le système de stockage objets », précisent les ingénieurs dans le billet de blog.
« Cela ajoute un peu de latence à chaque écriture, mais tout comme le trajet aller-retour entre régions, la sérialisation par référence empêche que cela ne devienne un goulet d’étranglement ».
Les répliques d’écriture sont virtualisées et exécutées par des nœuds éphémères. Ensuite, GitHub compte déployer « autant de répliques virtuelles de lecture que nécessaire », en fonction de la demande.
« Chaque réplique de lecture réchauffe son cache à partir d’Azure Blob Storage et commence à traiter le trafic de lecture sans rejoindre le quorum, en utilisant le stockage objet comme source de vérité et en synchronisant son état local avec celui-ci, en arrière-plan »
Pour tester cette architecture, GitHub a mis à l’épreuve un monorepo. Malgré les 5000 agents IA qui lisaient et écrivaient des données, l’éditeur a mesuré 7200 écritures concurrentes par seconde. Ce serait l’équivalent du trafic subi par un gros dépôt open source sur 24 heures, compressé en une minute.
« Concernant les lectures, notre propre harnais de tests de charge a atteint ses limites avant que la nouvelle architecture ne le fasse », avance April Leonard.
Se mettre à la vitesse de l’IA agentique
Pour rappel, Microsoft a acquis GitHub en 2019, mais la société a largement conservé son indépendance jusqu’à ce que Jay Parikh prenne la tête de l’équipe CoreAI en 2025. C’était aussi vrai pour son infrastructure. Désormais, GitHub fait partie intégrante de la stratégie du géant du cloud et a été mentionné à plusieurs reprises par Satya Nadella lors de la présentation des résultats du groupe, le 28 octobre. L’assistant agentique GitHub Copilot est désormais mentionné comme un moteur de la croissance des revenus du géant du cloud. « GitHub joue aujourd’hui le rôle le plus important qu’il ait jamais joué, dans la manière dont Microsoft fait évoluer l’ensemble de son activité », croit Kyle Daigle, chief operation officer chez GitHub.
Mais les hoquets de GitHub ont décidé Anthropic à bâtir son propre système Git. « Nous servons autant les startups, les sociétés à croissance rapide et les grands groupes », affirme Jay Parikh, lors d’un point presse. « Nous écoutons nos clients et faisons évoluer nos capacités en réponse à la demande ».
Thomas Dohmke, ex-CEO de GitHub, a lancé cette semaine sa startup Entire, une forge Git pensée pour l’IA agentique, qui accélérerait la vitesse des push de 89 % par rapport à GitHub.
« Je ne pense pas que le monde ait besoin d’un nouveau GitHub », complète Kyle Daigle. « Nos clients peuvent avoir besoin d’outils différents, mais ils ont surtout besoin que nous évoluions à l’aune de l’ère agentique. Et c’est ce que nous faisons ». Et les deux dirigeants de rappeler que 225 millions d’individus utilisent GitHub.
Crédits image en haut d’article : Jay Parikh, vice-président exécutif de l’équipe CoreAI chez Microsoft, prise par Gaétan Raoul pour LeMagIT.
Pour approfondir sur Outils de développement
-
![]()
Départ de Thomas Dohmke : Microsoft finit d'absorber GitHub
Par: Gaétan Raoul
-
![]()
Duo Self-Hosted : GitLab sort son assistant de codage IA sur site
Par: Gaétan Raoul
-
![]()
Administration : déboguez vos scripts PowerShell avec Visual Studio Code
Par: Anthony Howell
-
![]()
Comment utiliser Terraform pour configurer Azure Virtual Desktop
Par: Chris Twiest