
Splunk .conf26 : des serveurs plus chers pour la nouvelle surveillance des IA
Le nouveau module Splunk AI Tier aura besoin de serveurs plus performants pour exécuter les agents d’IA qui colmatent les problèmes causés par l’IA. Mais l’éditeur assure avoir tout mis en œuvre pour minimiser les coûts.
Les clients de l’environnement d’observation des ressources informatiques Splunk devront désormais compter avec un nouveau module : le Splunk AI Tier. Lors de sa conférence annuelle Splunk .conf26 qui se tenait la semaine dernière à Denver, l’éditeur a mis en exergue la nouvelle capacité de ses offres à déployer une AI Workforce, soit un personnel non humain, composé d’agents d’IA, qui a le mérite de fonctionner à la vitesse de la machine pour prévenir des incidents ou des cyberattaques susceptibles de se concrétiser plus vite que le temps de réaction d’un humain.
Il n’en reste pas moins que ce Splunk AI Tier, le moteur de cette AI Workforce, suppose à lui seul qu’il existe une infrastructure pour l’exécuter.
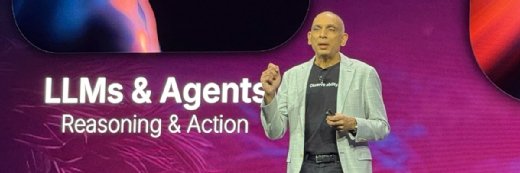
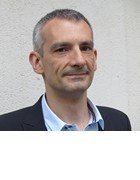
« Pour l’heure, Splunk AI Tier ne fonctionne qu’en cloud. Il sera possible de le déployer sur site d’ici à neuf mois », indique Mangesh Pimpalkhare, le directeur de la plateforme Splunk (en photo en haut de cet article). La plateforme Splunk constitue la colonne vertébrale de toutes les solutions (SIEM, maintenance du datacenter...) que commercialise l’éditeur. Le module Splunk AI Tier est une extension de cette plateforme.
« Concrètement, il s’agit d’un ensemble de containers Kubernetes qui exécutent des LLM, des agents qui les pilotent et des outils pour les configurer. D’ordinaire, les composants de Splunk n’ont pas besoin d’équipements spécifiques pour les exécuter. Mais s’agissant d’IA, vous avez besoin de GPU. C’est pourquoi nous avons techniquement séparé cette nouvelle partie du reste de la plateforme Splunk », explique Mangesh Pimpalkhare.
Une infrastructure pour exécuter Splunk AI Tier à part
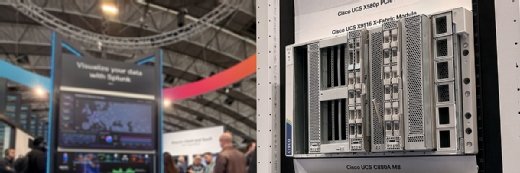
Juste avant qu’il s’entretienne avec LeMagIT, Mangesh Pimpalkhare avait présenté sur scène un bundle pour déployer un tel Splunk AI Tier. Il s’agissait en l’occurrence d’exécuter cette nouvelle couche logicielle sur un Cisco AI Pod, soit une ferme de serveurs UCS de Cisco – maison mère de Splunk – équipés de GPU. Une configuration matérielle autrement plus chère que les serveurs génériques habituellement nécessaires à Splunk.
« Oui, mais à partir du moment où vous souhaitez surveiller des IA que vous exécutez sur site, il vous faut de toute façon une infrastructure avec des GPU pour exécuter ces IA », rappelle Stéphane Estevez, de Splunk France, qui accompagne les clients de l’éditeur sur leurs projets d’observabilité.
« Le Cisco AI Pod est une possibilité parmi d’autres. S’agissant d’un ensemble de containers Kubernetes, le Splunk AI Tier est installable sur n’importe quelle autre infrastructure dotée de GPU que le client possède déjà. Cela dit, nous fournissons aussi une version complète, avec son propre Kubernetes, pour installer Splunk AI Tier sur des serveurs qui n’exécutent que lui », précise Stéphane Estevez. Il ajoute que les différents logiciels sont conçus pour fonctionner avec des GPU de marque Nvidia, lequel est présenté comme un partenaire pour l’instant exclusif.
Selon la documentation technique que Splunk vient de publier en ligne, cette version autonome de Splunk AI Tier aura besoin à minima d’un serveur de contrôle pour exécuter l’orchestrateur Kubernetes, d’un serveur de travail pour gérer toutes les fonctions de télémétrie et de configuration des agents d’IA, et de deux serveurs équipés des GPU pour exécuter les LLM interrogés par les agents. L’ensemble devrait au moins cumuler 256 Go de RAM pour les processeurs et 192 Go de VRAM pour les GPU, ainsi qu’un stockage de 1 To.
Il est important de noter que le stockage des télémétries (la plateforme Splunk) et les fonctions de surveillance habituelles (les consoles Observability et Security) s’exécuteront sur d’autres serveurs, en réseau.
« En théorie, vous pourriez exécuter toute la plateforme Splunk sur le cluster de serveurs qui exécute la partie Splunk AI Tier, mais ce ne serait pas optimal, car la plateforme Splunk, qui est constituée d’un data lake, de moteurs d’ingestion des métriques, voire qui est étendue par ses consoles de visualisation, n’a pas besoin de GPU chers pour fonctionner », dit Mangesh Pimpalkhare.
« Précisons en revanche que toutes les configurations sont possibles. Vous pouvez déployer la plateforme, les consoles et Splunk AI Tier individuellement sur site ou en cloud. Vous pouvez ainsi avoir un déploiement hybride, ou totalement étanche au reste d’Internet », ajoute Stéphane Estevez.
Selon ce dernier, si les déploiements tout en cloud sont généralement privilégiés aux USA, car le stockage des données y serait moins cher en ligne, Splunk a tout fait pour satisfaire les nouveaux besoins de souveraineté de ses clients européens. « Il est à ce sujet important de noter qu’il existe à présent un support 100% européen fourni par Cisco à tous ses clients, dont les clients des offres Splunk. Ce programme s’appelle le CNSC (Critical National Services Centers) et, en France, il est accrédité par l’ANSSI », dit Stéphane Estevez.
Minimiser la hausse de prix
Reste la question du prix supérieur que l’entreprise cliente devra investir dans une infrastructure bardée de GPU pour exécuter les LLM et les SLM avec lesquels interagissent les nouveaux agents de surveillance de ce module Splunk AI Tier.
Splunk explique avoir repensé la manière dont il facture ses clients pour minimiser l’augmentation des coûts.
D’une part, la plateforme Splunk de base sera désormais remplacée par une plateforme Cisco Data Fabric qui présente l’avantage d’indexer des métriques sans forcément devoir les stocker sur les disques des serveurs de calcul. Les anciennes métriques pourront être conservées sur des solutions de stockage objet peu chères, tandis que les nouvelles pourront être interrogées à distance depuis les serveurs qui les produisent.
D’autre part, trois nouvelles formules contractuelles font leur apparition dans les devis de Splunk : Activity-based pricing, Value-Insight pricing et Integrated Enterprise Value pricing.
« La première est la formule historique : il s’agit de facturer nos clients selon la quantité de métriques qu’ils demandent à la plateforme Splunk d’ingérer. La seconde correspond aux données qui ne sont plus ingérées dans la plateforme, mais juste indexées à distance. Pour une même quantité de métriques, cette seconde formule pourra vous coûter jusqu’à dix fois moins cher. La troisième correspond à un rabais si vous avez déjà acheté des solutions Cisco – des serveurs, des équipements réseau... - dans lesquelles il y a déjà un effort de télémétrie qui vous est facturé », détaille Mangesh Pimpalkhare.
Pour approfondir sur Administration de systèmes
-
![]()
Splunk .conf26 : la cybersécurité bascule dans l’ère des guerres de robots
Par: Yann Serra
-
![]()
Splunk .conf26 : la surveillance des agents d’IA enfin disponible
Par: Yann Serra
-
![]()
Serveurs pour l’IA : Cisco présente sa solution modulaire
Par: Yann Serra
-
![]()
Observabilité : Datadog pousse une stratégie hybride dans un marché en mutation
Par: Gaétan Raoul