
NetApp rend l’ingestion des données pour les IA plus universelle
NetApp dévoile à l'Insight 2026 une mise à jour de son AI Data Engine (AIDE). Le logiciel permet désormais la découverte et la gestion de données sur tout le parc de stockage, sans infrastructures intermédiaires pour les préparer en amont d’une IA.
Réduire la complexité de la plomberie qui sert à injecter les données d’une entreprise dans une IA locale. Tel est le propos de la nouvelle version du logiciel AI Data Engine (alias AIDE) que NetApp a présenté lors de sa conférence Insight 2026 qui se tenait la semaine dernière à Las Vegas. Lors de celle-ci, le fournisseur de solutions de stockage a plus que jamais mis l’accent sur les moyens pour concrétiser des déploiements d’applications d’IA, a fortiori agentiques, pour des entreprises qui se heurtent encore trop souvent à la complexité technique d’une telle aventure.
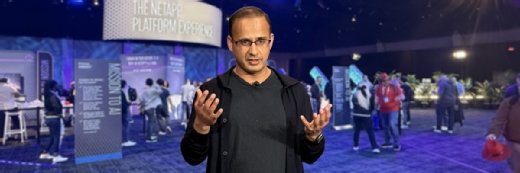
« Quand votre IA agentique ralentit ou bloque, le problème est rarement le modèle que vous utilisez, mais la disponibilité des données qui doivent alimenter ses analyses. Parce que ces agents fonctionnent à une vitesse et à des échelles bien supérieures que les humains lorsqu’ils manipulent une application. Donc nous avons amélioré notre logiciel d’injection de données AIDE avec des fonctions d’autodécouverte et d’indexation des données distantes. Et cela fonctionne avec toutes les solutions de stockage, toutes les nôtres et celles d’autres fournisseurs », dit Asad Khan, le patron des produits d’IA chez NetApp (en photo en haut de cet article).
Il résume l’avantage technique de cette nouvelle version par un slogan : « zéro copie ». Sous-entendu qu’il n’est plus nécessaire de passer par une étape où l’on copie les données produites au quotidien depuis différentes baies de disques vers un serveur intermédiaire qui change leur format, pour ensuite les copier à nouveau vers la baie de stockage accolée aux serveurs qui exécutent l’IA. Le logiciel AI Data Engine, qui fonctionne sur des serveurs équipés de GPUs, présente à une IA des données qu’elle sait interroger, avant qu’elles soient déplacées et sans même qu’il soit besoin de les convertir.
Une architecture en quatre couches pour rendre les données universelles
Le logiciel AIDE avait été présenté il y a un an pour accompagner une nouvelle baie de stockage NetApp appelée AFX et dont la particularité était de disposer d’un module de calcul, avec des GPU, qui convertissait au fil de l’eau toutes les données enregistrées par les collaborateurs en données exploitables par une IA. Cette nouvelle version fait la même chose, si ce n’est que les données sources n’ont plus besoin de se trouver sur les disques situés au plus proche des GPUs.
S’exécutant cette fois-ci sur des serveurs de calcul à part entière – a priori ceux dont une entreprise se sert pour son faire fonctionner son IA – la nouvelle version de AIDE commence par dresser en temps réel l’inventaire des données enregistrées sur n’importe quelle solution de stockage NAS (SMB, NFS), objet (S3) voire bloc (bases SQL) du réseau. Cet index devient un premier catalogue de métadonnées qui décrit aussi bien que possible les contenus et leurs droits d’utilisation.
« Il est important de noter que ces données deviennent, à partir de ce moment, interrogeables par n’importe quelle application d’analytique ou d’inventaire, via des API. C’est-à-dire que, sans même aller jusqu’à une IA agentique métier, les administrateurs du stockage peuvent dès ce stade se rendre compte des problèmes d’accès ou de capacités qui existent sur leurs différents silos de données », fait remarquer Asad Khan.
Il précise que les métadonnées présentent l’intérêt de classifier ce qui est du travail par rapport à ce qui n’est que fonctionnel (les documents par rapport aux fichiers de logs, aux programmes ou autres duplicatas, par exemple) et font le lien entre les contenus et les utilisateurs. Cette dernière fonctionnalité va par exemple permettre à un agent d’IA de savoir à qui s’adresser selon les contenus traités par son IA.
Une seconde couche intervient ensuite pour aspirer ces données et les stocker localement dans un format universel. Localement signifiant une baie de stockage qui est, elle, directement reliée aux serveurs de calcul, via des cartes réseau avec une très forte bande passante (400 ou 800 Gbit/s). Cette seconde couche est incarnée par le logiciel Nucleus de DataPelago, que NetApp a racheté en juillet.
« Le fait de ne pas passer par un système de conversion intermédiaire, comme un ETL avec un datalake, garantit que les permissions, les protections ou encore les hybridations [un fichier texte de sous-titres qui va de pair avec un fichier vidéo, par exemple, N.D.R] sont maintenues », assure Asad Khan.
En se servant des métadonnées générées en première instance, le logiciel va ensuite ranger les données dans une base orientée graphe. Ce type de bases de données est plus efficace qu’une base vectorielle pour les IA, car les données, en plus d’y être rangées par blocs entiers à des coordonnées sémantiques, sont finement placées les unes par rapport aux autres selon leur relation plus ou moins directe dans le contexte des applications métiers utilisées. Par exemple, des listes de clients vont se retrouver rangées ensemble, car elles ont un point commun sur le plan commercial, alors qu’elles étaient initialement stockées dans des fichiers différents.
« Il faut mesurer l’importance de cette couche. L’agent ne va pouvoir sélectionner qu’un fragment des données pour les soumettre à une IA. D’ordinaire, son choix est peu éclairé, car il n’a pas une vision précise de toutes les informations possibles. Avec ces métadonnées et cette base en graphe, il a cette vision précise et il va pouvoir soumettre à l’IA les données réellement les plus pertinentes », ajoute Syam Nair, le directeur des produits chez NetApp.
En dernière couche, AIDE propose des serveurs MCP auxquels les agents d’IA peuvent se connecter afin de choisir les données les plus pertinentes selon les instructions qu’on leur demande d’exécuter.
« Ici, tout est standard. Les données sont intégrables dans le système de votre choix. Vous pouvez les interfacer avec n’importe quel LLM, comme vous pouvez vous en servir pour réalimenter une autre base décisionnelle », argumente encore Asad Khan.
Puiser dans l’innovation logicielle pour aller au-delà de la pénurie de matériels
La mise à jour d'AIDE sera disponible dans le courant de ce mois et sera installable gratuitement jusqu’en mars pour tous les clients NetApp. Asad Khan évoque que ces évolutions futures concerneront la base graphe, dans le but d’augmenter graduellement sa polyvalence. NetApp prévoit notamment que son graphe de connaissances pourra s'intégrer ou se synchroniser avec d'autres graphes tiers, tout en restant compatible avec les standards du marché.
Le sujet de la préparation des données est devenu cette année celui de plusieurs autres fournisseurs d’infrastructure. Avant l’été, Dell avait présenté un logiciel Data Orchestration Engine pour convertir les fichiers en vecteurs, et EverPure avait lancé Data Intelligence pour faire à peu près la même chose, soit un inventaire sémantique des contenus et le stocker au plus proche des serveurs de calcul.
Selon l’analyste Shari Lava d’IDC, NetApp aurait cela dit la proposition la plus fluide : « la solution de NetApp est utile dans le sens où elle regroupe quatre étapes essentielles, à savoir la découverte des données, la compréhension de ce qu’elles signifient, leur gouvernance et leur mise à disposition. »
Dans un contexte de pénuries de mémoires NAND qui freine le lancement de nouvelles machines, il y a surtout pour les acteurs du marché du stockage de ne plus être perçus comme de simple vendeur de matériels. « Nous ne cesserons pas d'être une entreprise d'infrastructure, mais cela ne signifie pas que les infrastructures sont uniquement nos baies de stockage. Par infrastructure, j’entends un fonctionnement typique de NetApp qui va pouvoir se retrouver dans tous les datacenters, dans tous les clouds, chez tous les néoclouds, parce qu’il est hors pair », conclut Syam Nair.
Pour approfondir sur SAN et NAS
-
![]()
Virtual Graph : Neo4j parie sur la virtualisation des graphes
Par: Gaétan Raoul
-
![]()
Faute de NAND, EverPure mise sur l’édition de logiciels pour l’IA
Par: Yann Serra
-
![]()
Avec ses outils MCP, Atlassian dit réduire sa consommation de tokens
Par: Beth Pariseau
-
![]()
IA, Lakehouse : SAP rachète Prior Labs et Dremio, mais doit convaincre
Par: Gaétan Raoul