Shadow convertit ses PC gamers en cloud en services d’IA, utilisables le jour
Les PC virtuels bardés de GPU du prestataire français étant principalement utilisés par les joueurs la nuit, le prestataire français a eu l’idée de mettre leur puissance au service d’une IA en ligne durant les heures de bureau. L’offre se veut plus souveraine et moins coûteuse que celles des hyperscalers.
De l’inférence en cloud plus souveraine et avec des tarifs plus prédictibles pour les utilisateurs comme pour les développeurs. Telle est la promesse que veut désormais tenir le fournisseur français Shadow en lançant ces jours-ci deux nouveaux services en ligne : Blade Models et Blade AI Fabric.
Le premier donne accès à une interface en ligne depuis laquelle on sélectionne un LLM – on y trouve les principaux modèles d’IA à poids ouverts, pour le texte, les images, l’audio… – et on l’interroge comme une IA classique après avoir consulté son tarif par millions de tokens.
Et comme Blade Models dispose d’une API OpenAI standard, il est même possible d’utiliser le LLM choisi depuis une application de bureau agentique (OpenClaw, Anything LLM...) pour que l’IA interagisse avec des applications locales. Même sans cela, les modèles du service sont capables d’agrémenter leurs réflexions d’éléments tirés du web, car Blade les connecte à l’API Staan du moteur de recherche français Qwant.
Blade AI Fabric propose aux développeurs d’installer des commandes Shell et des bibliothèques Python sur leur machine, pour que leurs codes interrogent en ligne les mêmes LLM que ceux proposés par Blade Models. Il suffit de taper dans un terminal la commande blade run <nom_du_script_python.py> pour que le script en question se charge et s’exécute sur les serveurs en cloud de Shadow.
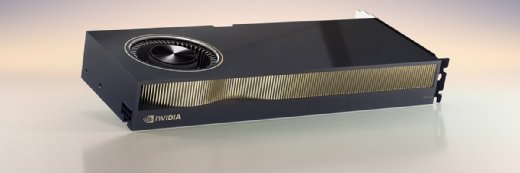
Cette fois, le service est facturé selon les ressources GPU et processeur : 40 centimes par heure pour une carte Nvidia RTX4500 dotée de 20 Go de RAM, la moitié pour une RTX2000 avec 16 Go et 5 centimes par heure par cœur de processeur. Sachant que ces tarifs sont évalués à la minute : utiliser une RTX4500 pendant 20 minutes ne coûtera que 13 centimes.
Les outils disponibles dans les consoles de pilotage en ligne des services Blade comprennent des programmateurs pour faire travailler l’IA lors des heures les moins chères, suivre la consommation, ou encore fixer un plafond budgétaire à ne pas dépasser.
« Nous avions donc un boulevard pour proposer nos propres services d’inférence avec une offre plus intéressante que ce qui existe déjà. »
Boris LecoeurPDG de Shadow
« Le marché de l’inférence pèse aujourd’hui 50 milliards de dollars et il devrait être multiplié par quatre ou six d’ici à 2030. Nous avions donc un boulevard pour proposer nos propres services d’inférence avec une offre plus intéressante que ce qui existe déjà », lance Boris Lecoeur, le PDG de Shadow, lors d’une conférence de presse consacrée à ces nouvelles solutions.
Et d’argumenter : « lorsque vous passez par un service d’IA en cloud classique, comme ceux offerts par les hyperscalers américains, non seulement les tarifs au token et au GPU utilisés sont nébuleux, mais vous n’êtes pas non plus certain de la législation qui s’applique aux travaux que vous soumettez à cette IA. »
Utiliser les GPU des PC Shadow quand les joueurs ne s’en servent plus
Voilà pour l’offre côté face. Côté pile, Shadow n’est autre que cette entreprise française qui s’est fait connaître dès 2015 en proposant sur le marché du jeu vidéo des PC gamers en cloud, dotés de cartes graphiques très puissantes, que les joueurs pouvaient payer à l’usage plutôt qu’acheter leur propre machine de compétition.
Or, la nouvelle activité autour de l’IA est directement liée à l’ancienne.
« Ces services nous permettent de mieux rentabiliser l’infrastructure que nous avons déployée. »
Boris LecoeurPDG de Shadow
« Très clairement, nos nouveaux services Blade sont un relais de croissance pour notre activité historique. Car ces services nous permettent de mieux rentabiliser l’infrastructure que nous avons déployée – actuellement 12 000 GPU sur trois datacenters en Europe et trois autres aux USA – et qui n’est véritablement utilisée par les joueurs qu’entre 19h00 et 10h00 le lendemain matin », explique Boris Lecoeur.
De fait, les tarifs indiqués plus haut sont ceux des services Blade en dehors des heures où les GPU sont sollicités par les joueurs ; les clients de tous les services étant cantonnés aux infrastructures présentes sur leur continent, donc dans des fuseaux horaires similaires. Shadow n’a pas mentionné à ce stade le montant du surcoût pour utiliser les services Blade la nuit, mais encourage ses utilisateurs à se servir de l’outil qui reprogramme leurs requêtes aux heures de la journée.
Dans le giron d’OVHcloud
Initialement appelée Blade, l’entreprise est passée sous le giron de l’entrepreneur Octave Klaba (patron et fondateur d’OVHcloud) au début des années 2020. Celui-ci l’a renommée Shadow et l’a intégrée à son groupe de technologies souveraines Synfonium, auquel appartient aussi le moteur de recherche Qwant. Selon Boris Lecoeur, Octave Klaba fixe aux sociétés de Synfonium de générer 1 million de chiffre d’affaires par mois, un objectif que l’activité des Shadow PC ne suffisait pas à atteindre.
Et, sans surprise, c’est dans les datacenters d’OVHcloud que l’infrastructure de Shadow est hébergée.
Il est à noter qu’OVHcloud propose lui aussi des services en ligne de GPU payables à la demande. Mais, d’une part, ces services ne sont pas des services d’IA autant clés en main. D’autre part, il ne s’agit pas des mêmes GPU. Les cartes RTX et Shadow sont conçues pour être utilisées à leur pleine puissance par un utilisateur à la fois, pendant un temps limité. Les cartes Nvidia haut de gamme d’OVHcloud – facturées entre 2,80 € et 76 centimes de l’heure – sont conçues pour servir plusieurs utilisateurs en même temps.
Une entreprise souscrira aux services de Blade pour exécuter des tâches individuelles et aux services GPU d’OVHcloud pour héberger une application d’IA qu’elle propose en libre-service à tous ses collaborateurs.
À ce titre, il est à noter qu’il manque aux services Blade des fonctionnalités installables chez OVHcloud. Il en va ainsi d’une base de données vectorielle pour constituer un entrepôt de documents dans lequel une IA peut piocher des connaissances à chaque requête.
« C’est typiquement quelque chose que l’utilisateur ou le développeur installeront localement, par exemple via une base de données Open source PostgreSQL avec son extension vectorielle, de sorte à soumettre aux services Blade uniquement les données issues d’une requête RAG. Laquelle serait donc prise en charge par votre client local ou votre script Python », explique Yohann Prigent, le directeur technique de Shadow.